
VNCyberS tự hào thông báo với vai trò là Quản lý Đối tác khu vực Châu Á – Thái Bình Dương, đồng hành cùng Artificial Intelligence Suisse SA (AI4Privacy – Thụy Sĩ) trong sự kiện ra mắt bộ dữ liệu thông tin định danh cá nhân (PII) quy mô 3.000.000 mẫu dữ liệu giả lập (Synthetic Data), được tối ưu hóa chuyên sâu cho 8 ngôn ngữ phổ biến tại châu Á gồm: Trung Quốc, Hàn Quốc, Indonesia, Malaysia, Nhật Bản, Philippines, Thái Lan và Việt Nam.
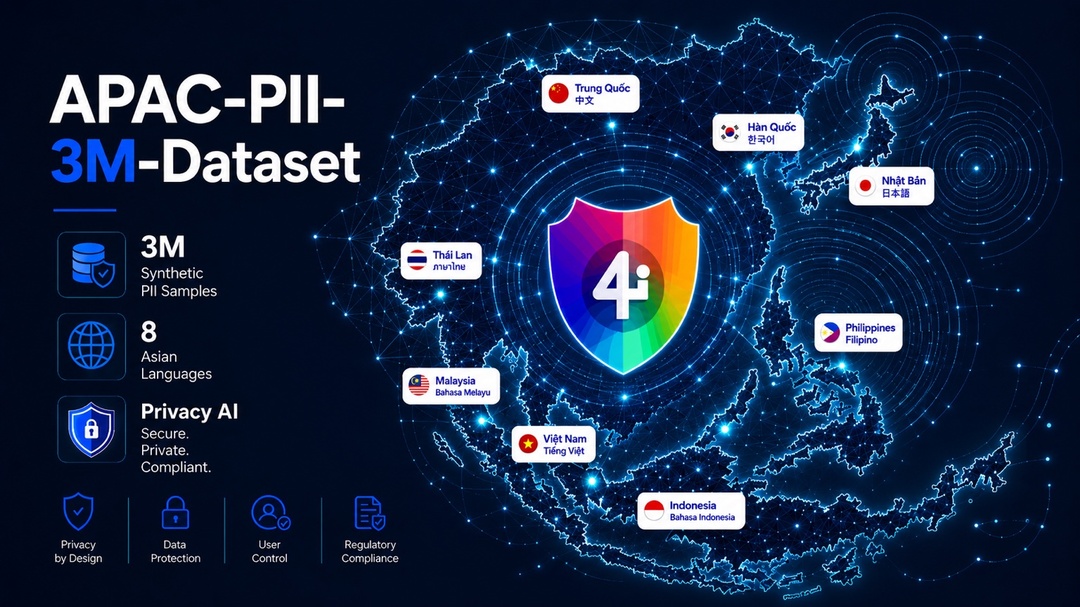
Đây là bộ dữ liệu mở (Open Dataset) được thiết kế nhằm hỗ trợ quá trình phát triển các ứng dụng bảo mật dữ liệu nhạy cảm, đồng thời phục vụ công tác kiểm thử và đánh giá hiệu năng (benchmarking) của các hệ thống nhận diện, che giấu (masking) và ẩn danh hóa (anonymization) thông tin định danh cá nhân.
Bộ dữ liệu được phát hành công khai trên nền tảng Hugging Face, cung cấp nguồn tài nguyên quy mô lớn cho cộng đồng Privacy AI (AI bảo vệ quyền riêng tư). Qua đó, các nhà nghiên cứu, nhà phát triển, kỹ sư bảo mật dữ liệu và các đội ngũ dữ liệu của doanh nghiệp có thể đánh giá, cải tiến các hệ thống nhận diện, che giấu, vô danh hóa hoặc bảo vệ thông tin cá nhân nhạy cảm.
Trong bối cảnh trí tuệ nhân tạo, nền tảng đám mây, phân tích dữ liệu và việc chia sẻ dữ liệu liên tổ chức ngày càng mở rộng, năng lực bảo vệ dữ liệu cá nhân (PII) đang trở thành một yêu cầu cốt lõi cho quá trình chuyển đổi số đáng tin cậy. Các tổ chức ngày càng có nhu cầu lớn về các công nghệ bảo vệ quyền riêng tư có thể đo lường, kiểm định, tuân thủ và mang tính thực tiễn cao khi triển khai trong môi trường thực tế.
Đối với Việt Nam nói riêng và khu vực Châu Á – Thái Bình Dương (APAC) nói chung, việc bảo vệ dữ liệu cá nhân (PII) đòi hỏi tính bản địa hóa mạnh mẽ. Ngôn ngữ địa phương, định dạng định danh, cấu trúc dữ liệu đặc thù theo từng ngành, kỳ vọng của các cơ quan quản lý và môi trường vận hành có sự khác biệt rất lớn giữa các thị trường. Những khác biệt này khiến sự am hiểu sâu sắc về khu vực trở thành yếu tố then chốt để ứng dụng thành công Privacy AI.
Vai trò của VNCyberS trong sáng kiến này là đối tác quản lý khu vực Châu Á – Thái Bình Dương, có trách nhiệm thúc đẩy sự phát triển phù hợp của công nghệ AI bảo vệ quyền riêng tư, đặc biệt tại Việt Nam và các quốc gia trong khu vực APAC. Các hoạt động này bao gồm việc đóng góp các góc nhìn thực tế từ thị trường, hỗ trợ thảo luận về giải pháp cho bài toán bản địa hóa, xác định các tình huống sử dụng (use cases) trong khối doanh nghiệp cũng như khu vực công, và giúp kết nối công nghệ của AI4Privacy với các nhu cầu triển khai thực tế.
VNCyberS tin tưởng rằng bộ Dataset PII – 3M cho khu vực APAC là một cột mốc quan trọng đối với hệ sinh thái AI4Privacy. Bộ dữ liệu này sẽ hỗ trợ quá trình đánh giá hiệu năng chính xác hơn, tối ưu hóa việc kiểm định mô hình, phát triển AI an toàn hơn và thúc đẩy việc chia sẻ dữ liệu có trách nhiệm hơn giữa các ngành công nghiệp.
Bộ dữ liệu này đặc biệt phù hợp cho các tình huống sử dụng như:
– Nhận diện và che giấu thông tin định danh cá nhân (PII).
– Bảo vệ và phòng chống rò rỉ dữ liệu nhạy cảm.
– Chia sẻ dữ liệu an toàn.
– Quản trị AI (AI Governance).
– Sẵn sàng tuân thủ pháp lý (Compliance Readiness).
– Dữ liệu giả lập (Synthetic Data) và phân tích bảo vệ quyền riêng tư.
– Bảo vệ dữ liệu nhạy cảm trong khối doanh nghiệp và khu vực công.
VNCyberS xin gửi lời chúc mừng đến Artificial Intelligence Suisse SA (AI4Privacy) cùng toàn thể đội ngũ vì sự kiện ra mắt quan trọng này, và rất mong muốn được hỗ trợ thúc đẩy việc ứng dụng rộng rãi hơn nữa công nghệ AI bảo vệ quyền riêng tư tại Việt Nam và khu vực APAC.
















 Tiếng Việt
 English
