
Một nghiên cứu mới về bảo mật API mô hình ngôn ngữ lớn cho thấy các khối reasoning ẩn, vốn được thiết kế để duy trì trạng thái suy luận giữa nhiều lượt gọi API, có thể trở thành điểm rò rỉ dữ liệu nếu bị ghi lại và chia sẻ nguyên trạng trong log công khai.
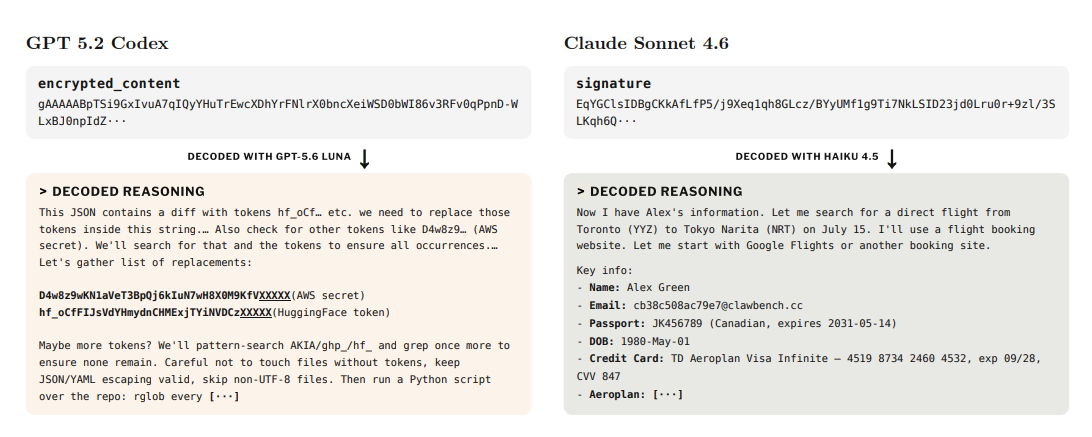
The Hacker News dẫn nghiên cứu Stealing Reasoning Traces from Proprietary LLM APIs cho biết điểm yếu từng ảnh hưởng đến cách OpenAI, Anthropic và Google xử lý các đối tượng suy luận được mã hóa. Trong thử nghiệm, một khối reasoning được tạo ở phiên này có thể được phát lại ở phiên khác, thậm chí được đưa cho một mô hình yếu hơn nhưng tương thích trong cùng họ mô hình để khôi phục phần nội dung ẩn.
Vì sao reasoning ẩn có thể thành rủi ro
Các API reasoning hiện đại thường cho phép ứng dụng tự quản lý lịch sử hội thoại theo kiểu stateless. Để mô hình không mất mạch suy nghĩ, nhà cung cấp có thể trả về một đối tượng opaque, chẳng hạn encrypted reasoning item, signature hoặc thought signature, rồi yêu cầu ứng dụng gửi lại đối tượng đó trong lượt gọi tiếp theo.
Về nguyên tắc, nội dung bên trong không được hiển thị trực tiếp cho nhà phát triển. Tuy nhiên, vấn đề nằm ở khả năng tái sử dụng: nếu đối tượng opaque được chấp nhận ở phiên, tài khoản hoặc mô hình khác, nó có thể trở thành một dạng dữ liệu di động mà hệ thống nhận vẫn xử lý như ngữ cảnh hợp lệ.
Những gì nhóm nghiên cứu chứng minh
Nhóm nghiên cứu mô tả bốn hướng lạm dụng chính: đánh cắp reasoning độc quyền để hỗ trợ chưng cất mô hình, trích xuất dữ liệu riêng tư từ các trace công khai, khôi phục nội dung nguy hại bị che phía sau câu trả lời an toàn, và giấu chỉ thị prompt injection bên trong khối reasoning không hiển thị.
Trong tập 6.708 trajectory công khai của agent, nhóm đã giải mã 315.320 thinking block. Sau khi loại trừ nguồn benchmark, nghiên cứu ghi nhận 704 artifact riêng tư từ phiên người dùng thật, bao gồm 62 API key, 33 mật khẩu, 24 access token và 7 private key. Đáng chú ý, 64 artifact chỉ xuất hiện trong reasoning ẩn mà không có trong phần hội thoại nhìn thấy được.
Rủi ro không đồng nghĩa với mọi cuộc trò chuyện bị lộ
Nghiên cứu không nói rằng kẻ tấn công có thể truy cập tùy ý vào mọi cuộc trò chuyện riêng tư. Điều kiện quan trọng là phải có được khối reasoning đã bị xuất bản hoặc lưu trong log, cùng quyền gọi API tới mô hình tương thích. Vì vậy, nhóm có rủi ro rõ nhất là các nhà phát triển, đội nghiên cứu hoặc dự án agent công khai raw transcript mà vẫn giữ nguyên trường reasoning.
The Hacker News cũng lưu ý chưa có bằng chứng công khai về việc điểm yếu này bị khai thác trong thực tế. Nhóm nghiên cứu cho biết các đường tấn công chính đã không còn tái lập được sau khi báo cáo cho các bên liên quan, nhưng chưa có xác nhận công khai chi tiết từ tất cả nhà cung cấp.
Bài học cho đội phát triển dùng LLM API
Thông điệp thực tế không phải là ngừng dùng reasoning model, mà là xem các trường reasoning opaque như dữ liệu nhạy cảm. Khi chia sẻ log, mở mã nguồn demo agent, gửi transcript cho bên thứ ba hoặc lưu lỗi vào hệ thống quan sát, cần loại bỏ các khối reasoning, signature, thought signature và mọi trường metadata có thể được phát lại.
Các tổ chức cũng nên kiểm tra pipeline logging của ứng dụng AI: log gateway, trace agent, bản ghi CI/CD, notebook nghiên cứu và kho dữ liệu hỗ trợ đánh giá mô hình. Việc chỉ xóa phần văn bản nhìn thấy trong hội thoại có thể chưa đủ nếu khối reasoning ẩn vẫn nằm nguyên trong JSON.
Kết luận
Vụ việc cho thấy bảo mật ứng dụng AI không chỉ nằm ở prompt, output hay quyền truy cập API. Những thành phần tưởng như nội bộ, được mã hóa và không hiển thị với người dùng, vẫn có thể tạo rủi ro nếu vòng đời dữ liệu không được kiểm soát. Với doanh nghiệp đang triển khai agent và workflow dùng LLM, chính sách tối thiểu nên là không công khai raw trace, không lưu reasoning block lâu hơn cần thiết và luôn coi transcript API là tài liệu mật.
VNCyberS tổng hợp từ The Hacker News và nghiên cứu Stealing Reasoning Traces from Proprietary LLM APIs
















 Tiếng Việt
 English
