APAC AI4Privacy

VNCybers hỗ trợ các tổ chức tại châu Á triển khai AI4Privacy

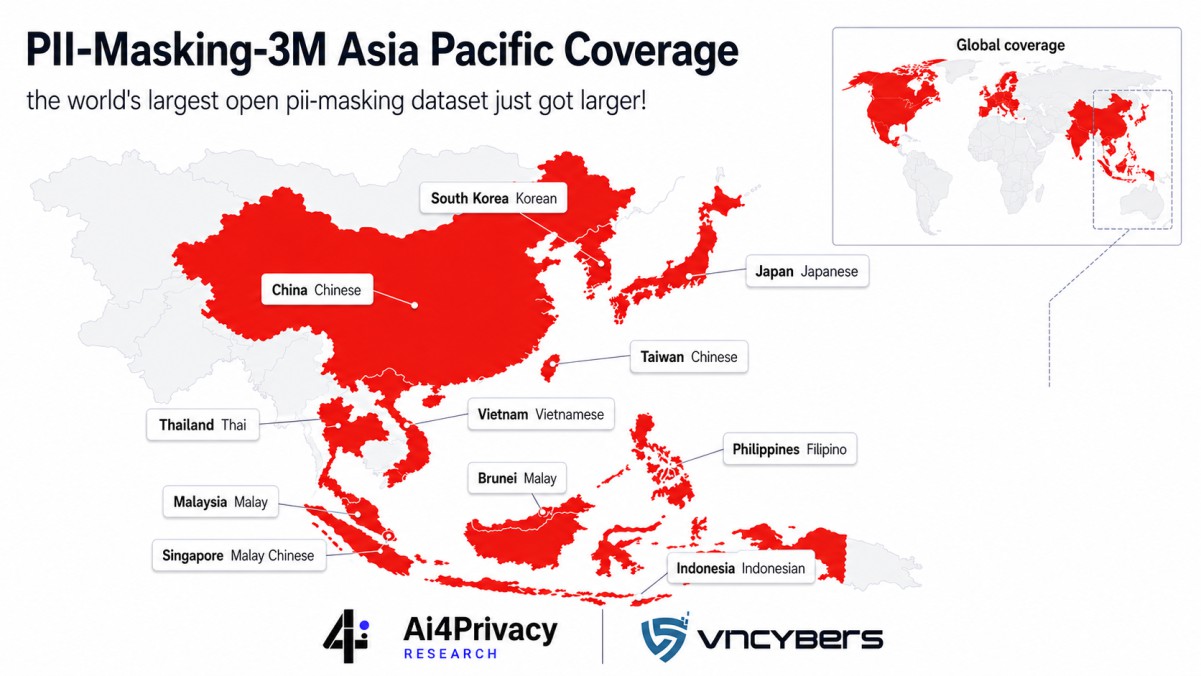
VNCyberS tự hào thông báo với vai trò là Quản lý Đối tác khu vực Châu Á – Thái Bình Dương, đồng hành cùng Artificial Intelligence Suisse SA (AI4Privacy – Thụy Sĩ) trong sự kiện ra mắt bộ dữ liệu thông tin định danh cá nhân (PII) quy mô 3.000.000 mẫu dữ liệu giả lập (Synthetic Data), được tối ưu hóa chuyên sâu cho 8 ngôn ngữ phổ biến tại châu Á gồm: Trung Quốc, Hàn Quốc, Indonesia, Malaysia, Nhật Bản, Philippines, Thái Lan và Việt Nam.

Chúng tôi tin rằng chia sẻ tri thức, chuyển giao công nghệ và phối hợp nghiên cứu với các đối tác toàn cầu chính là chìa khóa giải quyết những thách thức an ninh mạng xuyên biên giới ngày càng phức tạp.

Bộ dữ liệu PII Masking 3M Asia-Pacific mở rộng phạm vi dữ liệu che giấu thông tin cá nhân sang 30 ngôn ngữ, trong đó có tiếng Việt.

APAC AI4Privacy

1. Detect Personal Data – Phát hiện dữ liệu cá nhân
⛨ Nhận diện tên, số điện thoại, email, địa chỉ, mã định danh, tài khoản và nội dung nhạy cảm trong dữ liệu đa ngôn ngữ.

2. Mask & Protect PII – Che giấu và bảo vệ PII
⛨ Áp dụng masking, redaction, tokenization và controlled reveal để giảm rủi ro lộ lọt dữ liệu cá nhân.

3. Synthetic Data for Testing -Dữ liệu tổng hợp cho kiểm thử
⛨ Sử dụng dữ liệu tổng hợp thay cho dữ liệu cá nhân thật trong huấn luyện, kiểm thử, benchmark và PoC.

4. Compliance Readiness – Sẵn sàng tuân thủ
⛨ Hỗ trợ đánh giá quy trình bảo vệ dữ liệu theo PDP 2025, GDPR, PIPL, PIPA, PDPA và các khung privacy liên quan.

VÌ SAO AI4PRIVACY APAC QUAN TRỌNG?

Các tổ chức tại châu Á đang xử lý khối lượng lớn dữ liệu cá nhân trong ngân hàng, chính phủ, viễn thông, y tế và nền tảng số. Tuy nhiên, dữ liệu PII tại khu vực APAC có tính đa ngôn ngữ, đa định dạng, nhiều quy định pháp lý và khó sử dụng dữ liệu thật cho huấn luyện/kiểm thử AI.

🌎 Multilingual PII
⛨ PII tại APAC không chỉ là tiếng Anh. Hệ thống cần nhận diện tên, địa chỉ, số điện thoại, email và nội dung nhạy cảm trong nhiều ngôn ngữ khác nhau của châu Á.

📝 Country-Specific Formats
⛨ Các định dạng PII tại APAC khác nhau theo từng quốc gia, bao gồm tên, địa chỉ, số điện thoại, mã bưu chính và các mẫu định danh dạng tổng hợp.

🖥️ Synthetic Data for Safe Testing
⛨ Dữ liệu tổng hợp giúp huấn luyện, benchmark, kiểm thử PoC và đánh giá masking/tokenization mà không phải sử dụng dữ liệu cá nhân thật.

✅ Enterprise Compliance Readiness
⛨ Hỗ trợ đánh giá quy trình bảo vệ dữ liệu cá nhân theo PDP 2025, GDPR, PIPL, PIPA, PDPA và các khung pháp lý khác liên quan đến bảo vệ dữ liệu cá nhân.
PII-MASKING-3M APAC DATASET

⛨ Bộ dữ liệu tổng hợp quy mô lớn hỗ trợ phát hiện, che giấu, token hóa và đánh giá bảo vệ dữ liệu cá nhân trong bối cảnh đa ngôn ngữ châu Á.
⛨ PII-Masking-3M APAC Dataset là sáng kiến bộ dữ liệu tổng hợp quy mô lớn, được thiết kế để hỗ trợ các đội AI, kỹ sư bảo vệ dữ liệu và tổ chức doanh nghiệp kiểm thử năng lực phát hiện, phân loại và che giấu thông tin nhận dạng cá nhân trong nhiều ngôn ngữ châu Á.
⛨ Bộ dữ liệu giúp các tổ chức đánh giá các workflow như PII detection, masking, redaction, tokenization, controlled reveal và compliance-readiness mà không cần sử dụng dữ liệu cá nhân thật trong giai đoạn huấn luyện, thử nghiệm hoặc PoC.

1. 3M Synthetic Samples – 3 triệu mẫu dữ liệu tổng hợp
⛨ Kho dữ liệu tổng hợp quy mô lớn phục vụ huấn luyện, kiểm thử, benchmark và đánh giá các mô hình AI bảo vệ dữ liệu cá nhân.

2. 8 Asian Languages – 8 ngôn ngữ châu Á
⛨ Bao phủ các ngữ cảnh ngôn ngữ quan trọng tại APAC, bao gồm Vietnamese, Indonesian, Malay, Filipino, Thai, Chinese, Japanese và Korean.
3. PII Detection & Classification – Phát hiện và phân loại PII
Hỗ trợ nhận diện các nhóm dữ liệu như tên, số điện thoại, email, địa chỉ, mã định danh dạng tổng hợp, tài khoản, định danh số và nội dung nhạy cảm.

4. Masking & Tokenization Testing – Kiểm thử masking và tokenization
⛨ Cho phép đánh giá các kỹ thuật masking, redaction, pseudonymization, tokenization và controlled reveal trong môi trường an toàn.

5. Entity-Level Annotation – Gán nhãn theo thực thể
⛨ Các mẫu dữ liệu có thể được gán nhãn theo entity-level và span-level để hỗ trợ benchmark, huấn luyện mô hình NER và đánh giá độ chính xác của hệ thống.

6. Enterprise PoC Ready – Sẵn sàng cho PoC doanh nghiệp tổ chức
⛨ Hỗ trợ rút ngắn thời gian chuẩn bị PoC/Pilot cho ngân hàng, chính phủ, viễn thông, y tế và các nền tảng doanh nghiệp lớn.

8 ASIAN LANGUAGES

PII-Masking-3M APAC Dataset hỗ trợ đánh giá AI bảo vệ quyền riêng tư trên 8 ngôn ngữ châu Á và các mẫu PII theo ngữ cảnh từng quốc gia. Bộ dữ liệu được thiết kế để phản ánh các thách thức về quyền riêng tư trong môi trường đa ngôn ngữ tại APAC, bao gồm quy ước đặt tên địa phương, định dạng số điện thoại, địa chỉ theo kiểu bưu chính, dữ liệu dạng tài khoản, định danh số và các mẫu định danh dạng tổng hợp.

🇻🇳 Vietnamese
Tiếng Việt
Tên người, số điện thoại, địa chỉ và các mẫu định danh dạng tổng hợp.

🇮🇩 Indonesian
Tiếng Indonesia
Tên địa phương, định dạng số điện thoại/địa chỉ và dữ liệu dạng tài khoản.

🇲🇾 Malay
Tiếng Malay
Tên Malay, số điện thoại, mã bưu chính và các mẫu định danh dạng tổng hợp.

🇵🇭 Filipino
Tiếng Filipino
Các mẫu văn bản doanh nghiệp bằng tiếng Filipino và văn bản pha trộn Anh – Filipino.

🇹🇭 Thai
Tiếng Thái
Chữ Thái, tên địa phương, số điện thoại và định dạng địa chỉ.

🇨🇳 Chinese
Tiếng Trung
Tên tiếng Trung, địa chỉ, định dạng số điện thoại và các mẫu định danh dạng tổng hợp.

🇯🇵 Japanese
Tiếng Nhật
Tên Kanji/Kana, địa chỉ theo kiểu bưu chính và các mẫu PII theo ngữ cảnh Nhật Bản.

🇰🇷 Korean
Tiếng Hàn
Tên tiếng Hàn, số điện thoại, địa chỉ và dữ liệu dạng tài khoản.

Dataset Pipeline

PII-3M APAC Dataset được thiết kế theo pipeline dữ liệu có cấu trúc, hỗ trợ toàn bộ quy trình từ tạo dữ liệu tổng hợp, chuẩn hóa taxonomy PII, gán nhãn, kiểm thử masking/tokenization đến đánh giá mô hình và chuẩn bị PoC doanh nghiệp.

1. Synthetic Asian Text Data
⛨ Tạo dữ liệu tổng hợp đa ngôn ngữ theo ngữ cảnh APAC.

2. PII Entity Taxonomy
⛨ Chuẩn hóa nhóm thực thể PII và định dạng dữ liệu nhạy cảm.

3. Annotation & QA
⛨ Gán nhãn entity-level/span-level và kiểm định chất lượng.

4. Masking / Tokenization
⛨ Kiểm thử masking, redaction, tokenization và controlled reveal.

5. Evaluation & Enterprise Deployment
⛨ Đánh giá hiệu suất và chuẩn bị triển khai PoC/Pilot.

Enterprise Use Cases

PII-3M APAC Dataset hỗ trợ các tổ chức đánh giá và triển khai AI4Privacy trong nhiều tình huống sử dụng của doanh nghiệp, từ phát hiện PII, masking, tokenization, huấn luyện mô hình AI đến chuẩn bị PoC/Pilot bảo dữ liệu nhạy cảm và đánh giá sẵn sàng tuân thủ.

1. Benchmark phát hiện PII
⛨ Đánh giá hiệu suất phát hiện đối với tên, số điện thoại, địa chỉ email, địa chỉ cư trú, các mẫu định danh dạng tổng hợp, dữ liệu tài khoản, định danh số và nội dung nhạy cảm.

2. Kiểm thử masking và tokenization dữ liệu
⛨ Kiểm thử các quy trình masking, redaction, pseudonymization, tokenization và controlled reveal trước khi triển khai các ứng dụng trong môi trường doanh nghiệp.

3. Đánh giá sẵn sàng tuân thủ
⛨ Hỗ trợ đánh giá các quy trình bảo vệ dữ liệu cá nhân theo PDP 2025, GDPR, PIPL, PIPA, PDPA và các khung bảo vệ quyền riêng tư liên quan khác.

4. Huấn luyện và đánh giá mô hình AI
⛨ Hỗ trợ các đội AI/ML phát triển, fine-tune và đánh giá các mô hình NER, privacy classifier, redaction model và các hệ thống phát hiện dữ liệu riêng tư dạng hybrid.

5. Dữ liệu tổng hợp cho kiểm thử an toàn
⛨ Cho phép kiểm thử an toàn trong môi trường Dev, UAT, benchmark và PoC mà không cần sử dụng dữ liệu cá nhân thật.

6. Rút ngắn PoC / Pilot doanh nghiệp
⛨ Rút ngắn thời gian chuẩn bị PoC cho ngân hàng, cơ quan nhà nước, nhà mạng viễn thông, tổ chức y tế và các doanh nghiệp lớn.

VNCybers’ Role in APAC AI4Privacy

VNCybers hỗ trợ bản địa hóa, kết nối doanh nghiệp và phát triển thị trường APAC cho các sáng kiến AI4Privacy, bao gồm PII-Masking-3M APAC Dataset.

Với vai trò hỗ trợ phát triển thị trường APAC và bản địa hóa tại Việt Nam, VNCybers đồng hành cùng các tổ chức trong khu vực để đánh giá nhu cầu bảo vệ dữ liệu cá nhân, xác định use case doanh nghiệp, chuẩn bị PoC/Pilot và ứng dụng AI4Privacy vào các bài toán thực tế như PII detection, data masking, tokenization, synthetic data testing và compliance-readiness.

VNCybers tập trung hỗ trợ các tổ chức trong các lĩnh vực có yêu cầu cao về bảo vệ dữ liệu nhạy cảm như ngân hàng, chính phủ, viễn thông, y tế và nền tảng số, đồng thời kết nối các yêu cầu bản địa hóa của từng thị trường APAC vào quá trình phát triển và ứng dụng AI4Privacy.

1. APAC Localization Support – Hỗ trợ bản địa hóa APAC
⛨ Thu thập và phân tích yêu cầu ngôn ngữ, định dạng PII, bối cảnh pháp lý và use case doanh nghiệp tại Việt Nam và các thị trường châu Á.

2. Enterprise Use Case Advisory – Tư vấn use case doanh nghiệp
⛨ Hỗ trợ tổ chức xác định các bài toán phù hợp để ứng dụng AI4Privacy, bao gồm phát hiện PII, masking, tokenization, kiểm thử dữ liệu tổng hợp và đánh giá sẵn sàng tuân thủ.

3. PoC / Pilot Planning – Lập kế hoạch phương án kỹ thuật PoC/Pilot
⛨ Hỗ trợ xây dựng phạm vi thử nghiệm, tiêu chí đánh giá, dữ liệu kiểm thử tổng hợp, KPI kỹ thuật và lộ trình triển khai PoC/Pilot cho khách hàng doanh nghiệp.

4. APAC Market Engagement – Kết nối thị trường APAC
⛨ Hỗ trợ kết nối với các tổ chức, đối tác và khách hàng tiềm năng trong khu vực APAC, đặc biệt trong các lĩnh vực chính phủ, ngân hàng, viễn thông, y tế và công nghệ.

Khách hàng của chúng tôi

Chúng tôi tự hào được đồng hành cùng những thương hiệu tiên phong, tin tưởng giao phó cho chúng tôi sứ mệnh bảo vệ an toàn dữ liệu và biến tầm nhìn của họ thành hiện thực.

Cùng nhau, chúng ta sẽ tạo nên những điều kỳ diệu!

Liên hệ với chúng tôi

Email: [email protected]
Điện thoại: +84 903260277