
Ai4Privacy vừa công bố PII Masking 3M Asia-Pacific Release, bộ dữ liệu đa ngôn ngữ quy mô hơn 3 triệu mẫu tổng hợp phục vụ huấn luyện, đánh giá và tinh chỉnh các mô hình xử lý dữ liệu cá nhân theo hướng bảo vệ quyền riêng tư. Bản phát hành này mở rộng phạm vi sang khu vực châu Á – Thái Bình Dương, bổ sung các ngôn ngữ như tiếng Nhật, tiếng Hàn, tiếng Trung, tiếng Việt, tiếng Indonesia, tiếng Malay và tiếng Tagalog.
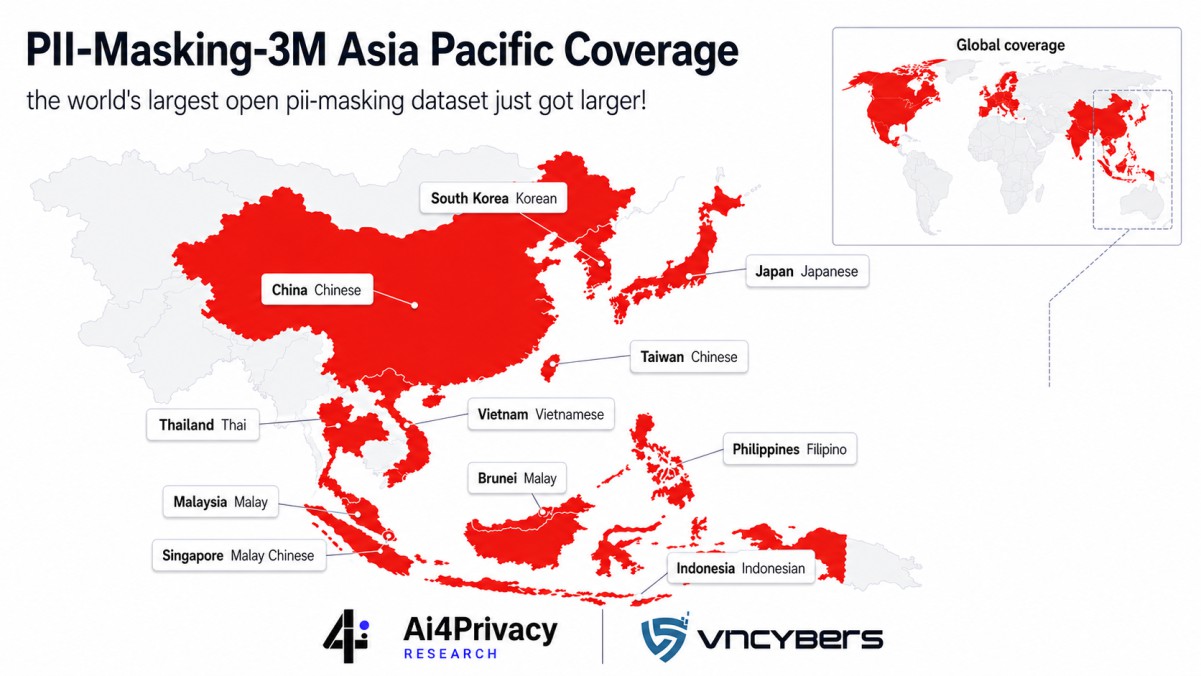
Trong thông báo chính thức, Ai4Privacy mô tả đây là một trong những kho dữ liệu mở đa ngôn ngữ lớn nhất dành cho bài toán che giấu thông tin định danh cá nhân, bao gồm hơn 3 triệu ví dụ tổng hợp trên 30 ngôn ngữ, trải rộng ở châu Âu, châu Mỹ và châu Á – Thái Bình Dương. Bộ dữ liệu được thiết kế cho các mô hình NLP cần nhận diện, phân loại, ẩn danh hoặc sinh văn bản có kiểm soát đối với dữ liệu nhạy cảm.
Bài gốc được công bố tại: https://www.ai4privacy.com/datasets/pii-masking-3m-asia-pacific/
Vai trò đối tác khu vực của VNCyberS
Phần mở rộng Asia-Pacific được Ai4Privacy giới thiệu là kết quả hợp tác cùng VNCyberS, đơn vị đóng vai trò đối tác khu vực trong mảng bảo vệ dữ liệu và an ninh mạng tại Việt Nam. Theo nội dung công bố, sự tham gia của VNCyberS nhằm bổ sung hiểu biết ngôn ngữ bản địa, bối cảnh khu vực và yêu cầu tuân thủ quyền riêng tư tại châu Á – Thái Bình Dương cho bản phát hành mới.
Điểm đáng chú ý là bộ dữ liệu không chỉ mở rộng về số lượng mẫu, mà còn mở rộng về phạm vi văn hóa – ngôn ngữ. Với các bài toán phát hiện PII, những khác biệt về cách viết tên người, địa chỉ, số giấy tờ, định dạng điện thoại, mã bưu chính, địa danh và hệ chữ viết có thể tạo ra sai lệch lớn nếu mô hình chỉ được huấn luyện chủ yếu trên dữ liệu tiếng Anh hoặc châu Âu.
Quy mô và cấu trúc bộ dữ liệu
Bộ sưu tập PII Masking 3M Asia-Pacific bao gồm 6 bộ dữ liệu chính và 5 lát cắt benchmark mở. Thành phần lõi mở rộng là OpenPII 1.5M với khoảng 1,64 triệu dòng, hỗ trợ 30 ngôn ngữ, 20 nhãn thực thể PII cốt lõi và giấy phép CC-BY-4.0.
Các thành phần enterprise được thiết kế cho những lĩnh vực có mức độ nhạy cảm cao hơn, bao gồm dữ liệu công việc và nhân sự, dữ liệu tài chính, dữ liệu vị trí và đi lại, dữ liệu y tế, cùng dữ liệu kỹ thuật số. Các tập này bao phủ những thông tin như chức danh, tổ chức, lương, số tài khoản, thẻ thanh toán, ví crypto, tọa độ địa lý, mã sân bay, chẩn đoán, thuốc, kết quả xét nghiệm, tên bệnh viện, tên người dùng, mật khẩu, API key, địa chỉ MAC, IMEI, OTP và user agent.
Các lát cắt benchmark mở
Ai4Privacy cũng cung cấp 5 lát cắt benchmark và sample theo giấy phép CC-BY-4.0 để phục vụ đánh giá nhanh, thử nghiệm pipeline và so sánh giữa các nhà cung cấp mô hình hoặc API. Các lát cắt này gồm OpenPII Micro 100K, OpenPII Nano 1K, PII Masking Micro 100K, PII Masking Mini 10K và PII Masking Nano 1K.
Những benchmark nhỏ có giá trị thực tế đối với nhóm kỹ thuật vì chúng giúp kiểm tra chất lượng phát hiện PII trong quy trình CI/CD, smoke test mô hình mới, đo sai lệch theo ngôn ngữ và đánh giá khả năng xử lý thực thể nhạy cảm mà không cần tải toàn bộ bộ dữ liệu enterprise.
Phủ sóng 30 ngôn ngữ trên 3 khu vực
Phạm vi ngôn ngữ của bản phát hành được chia theo 3 khu vực chính. Nhóm Asia-Pacific bổ sung 7 ngôn ngữ mới gồm tiếng Nhật, tiếng Hàn, tiếng Trung, tiếng Việt, tiếng Indonesia, tiếng Malay và tiếng Tagalog. Nhóm châu Âu bao gồm nhiều ngôn ngữ như tiếng Anh, tiếng Đức, tiếng Pháp, tiếng Tây Ban Nha, tiếng Ý, tiếng Hà Lan, tiếng Ba Lan và tiếng Thụy Điển. Nhóm châu Mỹ bao phủ tiếng Anh Mỹ, Tây Ban Nha khu vực Mỹ Latinh, Bồ Đào Nha Brazil và tiếng Pháp Canada.
Cách tiếp cận này phản ánh nhu cầu ngày càng rõ của thị trường AI: mô hình bảo vệ quyền riêng tư không thể chỉ hoạt động tốt với một vài ngôn ngữ phổ biến. Khi ứng dụng AI được triển khai toàn cầu, hệ thống ẩn danh và phát hiện dữ liệu cá nhân phải hiểu được đặc trưng ngôn ngữ, vùng lãnh thổ và cấu trúc dữ liệu địa phương.
Dữ liệu mẫu và nhãn thực thể
Mỗi mẫu dữ liệu gồm văn bản nguồn, văn bản đã được che giấu, danh sách thực thể trong privacy mask, ngôn ngữ, vùng và hệ chữ viết. Ví dụ được Ai4Privacy công bố cho tiếng Nhật cho thấy địa danh, tên đường, số nhà và mã bưu chính được thay bằng các placeholder như [CITY_1], [STREET_1], [BUILDINGNUM_1] and [ZIPCODE_1].
Nhóm nhãn PII cốt lõi bao gồm ngày tháng, tên, họ, email, thành phố, chức danh, số điện thoại, tuổi, đường phố, số nhà, mã bưu chính, số căn cước, số thẻ tín dụng, số giấy phép lái xe, giới tính, mã số thuế, số an sinh xã hội, số hộ chiếu và URL. Bản enterprise mở rộng thêm các nhãn chuyên ngành như chẩn đoán, thuốc, kết quả xét nghiệm, tên bệnh viện, IBAN, số tài khoản, BIC, lương, chức danh, tổ chức, API key, mật khẩu, địa chỉ MAC, tọa độ địa lý và mã định danh phương tiện.
Các use case chính
Bộ dữ liệu hỗ trợ ba nhóm tác vụ chính. Thứ nhất là Named Entity Recognition, cho phép huấn luyện mô hình nhận diện và phân loại thực thể PII với nhãn BIO tương thích mBERT đã được chuẩn bị sẵn. Thứ hai là ẩn danh dữ liệu, giúp xây dựng pipeline che giấu thông tin cá nhân phù hợp với các khuôn khổ như GDPR, EU AI Act, PDPA, APPI và PIPA. Thứ ba là tinh chỉnh mô hình ngôn ngữ lớn cho các tác vụ sinh văn bản và biên tập nội dung có nhận thức về quyền riêng tư.
Với doanh nghiệp, các bộ dữ liệu dạng này có thể trở thành nền tảng để kiểm thử hệ thống lọc PII trước khi đưa dữ liệu vào AI, chatbot, công cụ tìm kiếm nội bộ hoặc quy trình phân tích văn bản. Với nhóm nghiên cứu, dữ liệu đa ngôn ngữ giúp đánh giá công bằng hơn giữa các mô hình, đặc biệt ở những ngôn ngữ thường bị thiếu đại diện trong benchmark quốc tế.
Ý nghĩa đối với an toàn dữ liệu tại Việt Nam và khu vực
Việc tiếng Việt xuất hiện trong bản mở rộng Asia-Pacific là tín hiệu đáng chú ý. Trong thực tế, dữ liệu cá nhân tại Việt Nam có nhiều đặc thù như cấu trúc họ tên, dấu tiếng Việt, địa chỉ nhiều cấp hành chính, số định danh, số điện thoại, email, tài khoản ngân hàng, thông tin y tế và dữ liệu giao dịch số. Nếu hệ thống phát hiện PII không được kiểm thử trên dữ liệu phù hợp, rủi ro bỏ sót hoặc che giấu sai là rất lớn.
Ở cấp độ rộng hơn, bản phát hành cho thấy nhu cầu xây dựng hạ tầng dữ liệu phục vụ AI có trách nhiệm đang tăng nhanh. Khi các tổ chức đưa AI vào chăm sóc khách hàng, phân tích tài liệu, tự động hóa vận hành và quản trị tri thức, việc nhận diện và che giấu dữ liệu cá nhân không còn là tính năng phụ. Đây là lớp kiểm soát bắt buộc để giảm rủi ro rò rỉ, tuân thủ quy định và duy trì niềm tin của người dùng.
Thông tin truy cập
Người dùng có thể xem bộ dữ liệu trên Hugging Face thông qua trang công bố của Ai4Privacy. Các thành phần mở và benchmark được cung cấp theo giấy phép CC-BY-4.0, trong khi các bộ dữ liệu enterprise yêu cầu giấy phép thương mại. Ai4Privacy cũng cung cấp tùy chọn liên hệ để tổ chức có thể truy cập đầy đủ bộ dữ liệu 3M, bao gồm các thành phần chuyên ngành và phạm vi Asia-Pacific.
VNCyberS tổng hợp từ Ai4Privacy
















 Tiếng Việt
 English
